返回
AI時代一天讀5分鐘,萬本書刊隨選隨看!最高贈250元超商禮券
全球AI算力競賽掀起浪潮
為了突破記憶體牆與百千瓦散熱瓶頸,谷歌、亞馬遜、微軟與Meta在新世代產品中,全數轉向高密度全液冷整機櫃交付。這場硬體型態革命不僅改寫雲端算力規則,還引爆台灣伺服器與散熱供應鏈的價值大升級。
文●魏聖峰
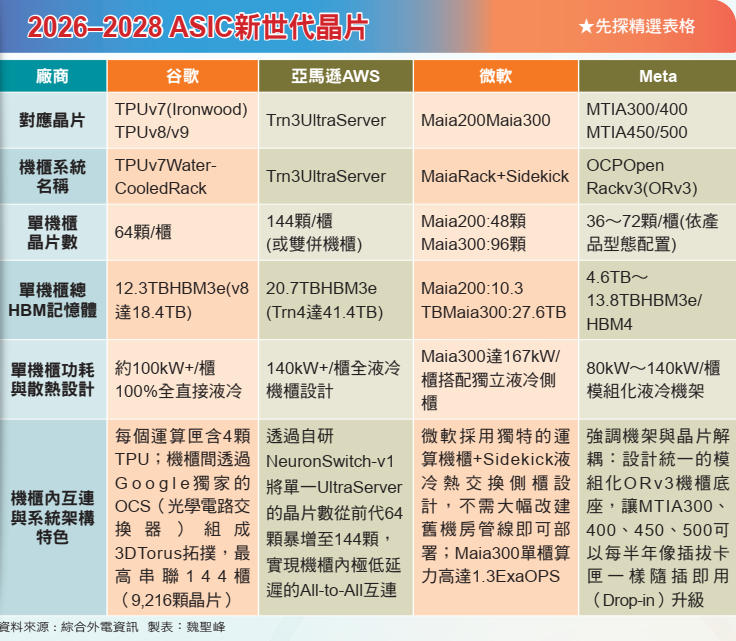
今年以前北美四大CSP業者砸下數千億美元資本支出建資料中心,很大一部分都轉化為Nvidia高達七五%毛利。今年四大CSP業者的自研晶片越來越成熟,逐漸扛起資料中心的核心運算主力。更關鍵的硬體變化是,AI ASIC競爭已全面升級為動輒100kW以上,並整合數十到上百顆晶片的全液冷整機櫃系統。從IP、晶圓代工、先進封裝到整機櫃液冷組裝,牽動全球半導體與伺服器供應鏈重組。
今年以前雲端資料中心內,大多以訓練數億參數基礎模型為主,從今年起全面跨入推論優先的商業變現模式。訓練一個前沿基礎模型要動用到數萬顆頂級晶片好幾個月,並屬於一次性的資本投入。反觀現在每天服務數十億用戶的搜尋摘要、程式碼生成、即時語音互動以及需要自主規劃和多步驟反思的代理式AI(Agentic AI),每次回答的背後都要生成數千甚至數萬個隱藏Token。根據業界統計,今年大型雲端機房已有超過七成的電力和算力消耗在推論的工作負載上。四大CSP業者在今年推出的自研ASIC上,直接定義用在推論。
訓練和推理合為一體的晶片
谷歌在去年發表的TPU v7(Ironwood)時直接定義為首款專為推論時代設計的TPU。微軟今年初發表的Maia 200與最新公布的Maia300中,也捨棄傳統訓練邏輯,全面針進行硬體最佳化,讓微軟在運行自家Copilot與OpenAI模型時,每瓦特電力產出的Token數量較商用GPU大幅提升一.七倍以上。亞馬遜把Trainium 3和Trainium 4定義為專為代理式AI與把極致Token經濟學打造的訓練和推理合為一體的主力晶片。Meta把MTIA 300/400/450/500定義為,拒絕將訓練晶片降維拿來做推論,全面轉向推論優先與兩年四代敏捷硬體。對CSP業者而言,訓練大語言模型固然重要,是在業界維持領先的必要條件,代理式AI才能吸引更多客戶,是將AI變現的最重要途徑。